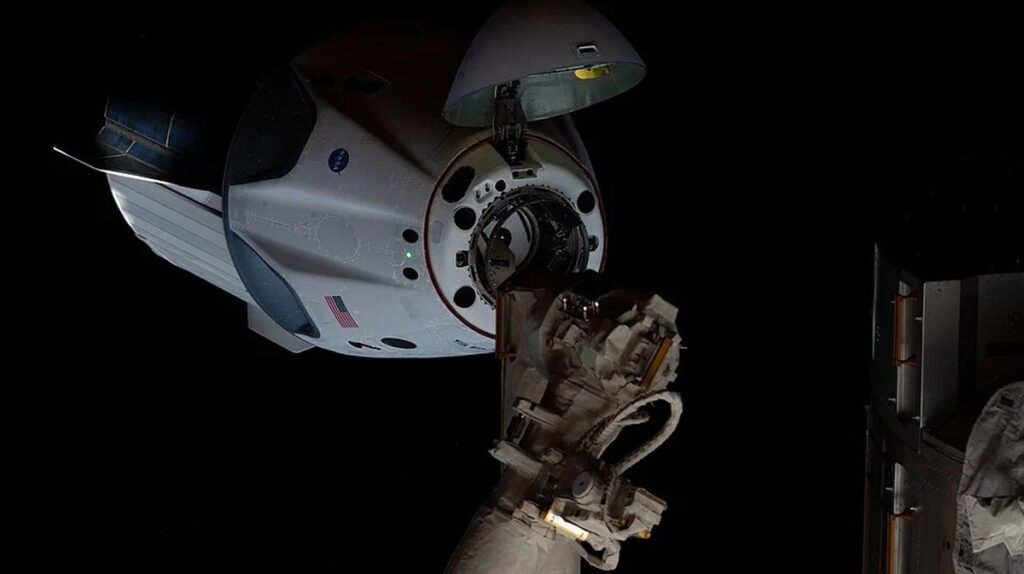
Uluslararası Uzay İstasyonu‘na (ISS) dokunmak, ilk bakışta basit bir hareket gibi görünebilir; ancak gerçekte bu işlem, orbital mekaniğin ne kadar zorlu olduğunu gösteren bir efsaneyi andırır. İki araç, saatte 28 bin kilometre hızla bir otoyolda ilerlerken, aynı hızda giden milyar dolarlık bir laboratuvarın içine tam park edebilecek kadar hassas bir manevrayı gerçekleştirmekle eşdeğerdir. İlerlemek için gaz verdiğinizde aslında yukarı kayarsınız, sizi doğal olarak yavaşlatan hava sürtünmesi yoktur ve hedefe çarparsanız hem aracınızdaki hem istasyonun içindeki herkes hayatını kaybeder; ortaya çıkan parçacıklar dozens uzay araçlarını ve hatta yeryüzündeki insanları bile etkileyebilir. Stanford Üniversitesi’nden araştırmacıların yeni bir makalesiyle ortaya çıkan yapay zekâ, tam da bu tür dokunma manevralarını gerçekleştirmek için “zihinsel simülasyonlar” yapmayı öğreniyor ve geleceğin uzay araçlarının birbirleriyle nasıl etkileşime gireceğini temelden değiştirebilecek bir yaklaşım sunuyor.
Bu yaklaşımın adı Out-of-this-World-Model (OWM), yani “Bu Dünyadan Farklı Model”. Araştırmacılar, bu modeli arXiv ön baskı platformunda paylaştıkları yeni makalelerinde, yapay zekânın gelecekteki uzay araçlarının birbirleriyle etkileşimini kökten dönüştürebileceğini öne sürüyor. Ancak OWM’ye geçmeden önce, Low Earth Orbit (LEO), yani Düşük Yerküre Yörüngesi’nde nasıl bir yolculuk yaptığımızı anlamak için kısa bir geri dönüş yapmak yerinde olur.
Dokunmanın Zorlu Fizik ve Geleneksel Algoritmalar
Geleneksel olarak navigasyon bilgisayarları, Guidance, Navigation and Control (GNC), yani Rehberlik, Navigasyon ve Kontrol adı verilen bir algoritma türünü kullanır. Bu sistemler, GPS alıcılarından ve yıldız izleyicilerden gelen verileri bir Extended Kalman Filter, yani Genişletilmiş Kalman Filtresi adı verilen bir matematiksel yöntemle işler ve ardından iticilerin çalıştırılma döngülerini belirler. Kalman filtreleri yüksek hızlı görüntü işlemede ise oldukça zayıftır; bu yüzden mühendisler geleneksel bilgisayar görme tekniklerine yönelir. Ancak bu teknikler uzayda kendileri için de ciddi bir zorlukla karşı karşıyadır: güneş ışığı bir güneş panelinden yansıyorsa ya da hedefin bir kısmı aniden gölgeye kaplanıyorsa, bu bilgisayar görme algoritmaları tamamen bozulur.
Bu durum, yapay zekâ için neredeyse biçilmiş kaftan gibi görünüyor. Araştırmacılar da aynı kanaatteydi ve bilgisayarların satranç ya da Dota gibi oyunlarda kazandığı o ünlü Reinforcement Learning (RL), yani Pekiştirmeli Öğrenme algoritmalarına başvurdu. Ancak bu algoritmalar yalnızca çok spesifik kurallar setine sahip senaryolarla başa çıkabilmektedir. Örneğin, ISS’e bağlanmanız gereken dokunma portunun hangi tarafında olduğunu değiştirmeniz yeterlidir; algoritmalar ne yapacaklarını bilemez. İşte tam bu noktada “World Model”, yani Dünya Modeli devreye giriyor.
Dünya Modeli: Beyinde Topu Takip Eden Bir Oyuncu
Dünya Modeli türündeki algoritmaları en iyi şekilde anlamak için bir voleybol ya da kriket oyuncusuyla bir benzetme yapmak mümkündür. Saha içinde topa ulaşmak için koşan bir dış saha oyuncusu, topun nereye düşeceğini hesaplamak için anında kısmi diferansiyel denklemler çözmez; bunun yerine topun nereye ineceğini tahmin eden bir zihinsel simülasyonla hareket eder. Bu zihinsel simülasyon geçmiş görsel ipuçlarına dayanır, ancak doğrudan hesaplamalarla pek ilgisi yoktur.
Makine öğreniminin dünyasında ise Dünya Modeli, ortamın temel fizik kurallarını ona doğrudan programlanan denklemlerden ya da belirli bir pekiştirmeye dayalı güncellemelerden değil, deneyimden öğrenen bir yapay zekâ mimarisidir. Stanford’ın OWM modeli bu fikri kullanarak onlarca potansiyel geleceği “rüya” görür ve sistemi bu rüya geleceğine doğru “adım” atmaya yönlendirir. Önemli olan nokta, modelin yalnızca tahminde bulunması değil; aynı zamanda bir sonucun olasılığını da ölçmesidir. Bu kesinlik, bir yapay zekânın beklenmedik durumlara tepki verebilmesini ve bazı sonuçlarının tam olarak gerçekleşmemesi halinde bir çıktıyı ayarlayabilmesini garanti altına alan temel unsurdur.
Yıllarca Sürdüğü Zorluk: Modeli Eğitmek
Yine de böyle bir modeli eğitmek, en büyük zorluğu temsil etmeye devam ediyor. Bir dünya modelinin yüz binlerce simüle edilmiş uçuşu gerektirmesi beklenir; bunu geleneksel bir bilgisayarın işlemcisinde (CPU) yapmak haftalar sürerdi. Araştırmacılar bu sorunu çözmek için AstroJAX adını verdikleri bir kütüphane geliştirdi. Bu kütüphane, erken dönem yapay zekâ modellerinin eğitimine yön verdiği Grafik İşleme Birimleri (GPU) üzerinde çalışacak şekilde tasarlanmıştır; ancak asıl olarak video oyun bilgisayarlarında kullanılmak üzere kurgulanmıştı.
Emeğin sonucunda ortaya çıkan algoritma beklentilerin üzerinde bir performans sergiledi. OWM modeli, dokunma manevralarını öğrenmek için yalnızca 500 bin iterasyon gerektirirken, buna benzer bir RL sistemi bunun 25 milyon permütasyonuna ihtiyaç duyuyordu. OWM modeli, ISS üzerinde daha önce hiç görülmemiş bir dokunma portuna bağlanırken de daha iyi performans gösterdi ve beklenmedik durumlara daha iyi tepki verebildi; araştırmacılar, yapay zekânın bağlanması gereken portta kasıtlı olarak bir kapsülü yerleştirdiği senaryolarda da bunu kanıtladı.
Henüz Uzun Yolun Başında
Elbette bu yazılımda geliştirme açısından hâlâ uzun bir yol geride kalıyor. ISS üzerindeki tüm dokunma portlarında model, başarıyla bağlanma oranını yalnızca yüzde 53’e ulaştı; ancak bu oran, RL algoritmasının yüzde 29 başarı oranıyla kıyaslanmalıdır. Buna rağmen yakın mesafe işlemleri OWM için zorlayıcı göründü; muhtemelen çarpışmaların yüksek ceza ağırlığından kaynaklanan bu durum, yazarların gelecekteki sürümlerde ayarlanabileceğini belirttiği bir unsurdur.
Tamamen otomatik bir yapay zekânın bir dokunma dizisini kontrol etmesini görmek muhtemelen uzun süre alacak; her iki uçta da insan bulunan herhangi bir sistemi kontrol etmesini görmek ise muhtemelen çok daha uzun sürecektir. Yine de önümüzdeki on yıllarda ya hizmete muhtaç ya da yörünge dışına indirilmeye muhtaç artan sayıda uydu ve uzayda kendiliğinden çoğalacak insan sayısı göz önüne alındığında, robotun direksiyona geçmesi yalnızca bir zaman meselesidir. Bu durumda söz konusu olan direksiyon değil, elbette itici kontrolüdür.
Yapay zekânın dokunma manevralarını bu kadar az iterasyonla öğrenmesi, geleneksel yöntemlere kıyasla ne kadar daha verimli bir yaklaşım olduğunu gösteriyor; ancak insan hayatının söz konusu olduğu durumlarda tam otomasyona geçmeden önce, beklenmedik durumlara tepki verme yeteneğinin ne kadar kritik olduğunu unutmamak gerekir.
Stanford Üniversitesi Araştırmacıları
Bu makalenin arka planında, uzayın giderek yoğunlaşması yatıyor. Son yıllarda yörüngeye bırakılan uydu sayısı hızla artıyor; bu durum, eski ya da kullanımdan çekilen araçların ya yeniden hizmete alınması ya da kontrollü biçimde yörünge dışına indirilmesi için giderek daha sık dokunma manevraları gerektiriyor. İşte Stanford’ın bu çalışmasının asıl önemi burada gizli: geleceğin uzay araçlarının, insan müdahalesine dayanmadan, kendi fizik kurallarını deneyimden öğrenerek birbirleriyle daha akıllıca etkileşime girmesinin temellerini atması.
Araştırmacılar, yakın mesafe işlemlerindeki zorlukların gelecekteki sürümlerde çözülebileceğini belirtiyor; özellikle çarpışmaların ceza ağırlığının ayarlanabilir olması, modelin hassas dokunma manevralarını geliştirmesine olanak tanıyor. Yine de insanlı uzay operasyonlarında tam otomasyonun gerçekleşmesi, teknolojinin olgunlaşması ve güvenin kazanılması açısından uzun bir süreç gerektirecek. Ne var ki, uzayın giderek daha kalabalıklaşması ve araç sayısının artması, robotların bu hassas görevlerde insanın yerini zamanla almasını kaçınılmaz kılıyor.


GÖZLEM DEĞERLENDİRMELERİ (1)